一起来看一下成品:
准备工具/素材/思路
1.思路
这期教程的视觉灵感来源于抖音创作者 @栖光。
我没有直接照搬某一条视频,而是先收集多个参考视频,让 Codex 分析其中反复出现的构图、建筑、人物比例、色彩和空间关系,再根据这些特点创作一套新的画面。
整个过程可以概括为:
参考视频整理 → Codex逐镜头分析 → Midjourney生成图片 → 根据测试结果修改提示词 → 可灵3.0生成视频 → 剪映拼接与配乐 → 将成熟流程封装成Skill。
这套方法的重点不是一次写出完美提示词,而是通过不断测试,逐步说清楚自己真正想要的效果。
2.准备工具
ChatGPT https://chatgpt.com/c/
Midjourney https://www.midjourney.com/imagine
倘若不知道模型怎么使用,可以参考这个教程(https://www.super-i.cn/info-2796.html),与本教程一起使用
https://www.flowpix.club/bj/37816.html?token=7d57c8481d6a363de100be562dc84661
3.准备素材
这是我下载的几条参考视频:
第一步:让 Codex 逐镜头反推图片提示词
在 Codex/Chat GPT 中上传视频,或者直接提供视频文件夹路径。
我使用的第一段提示词是:
帮我看下这个文件夹中的视频,先仔细地看下视频内容,然后告诉我怎么反推这个视频中每个单个画面的提示词。提示词要符合Midjourney v8.2的生成格式,英语。然后帮我创建一套新的类似的、宏大的国风场景。
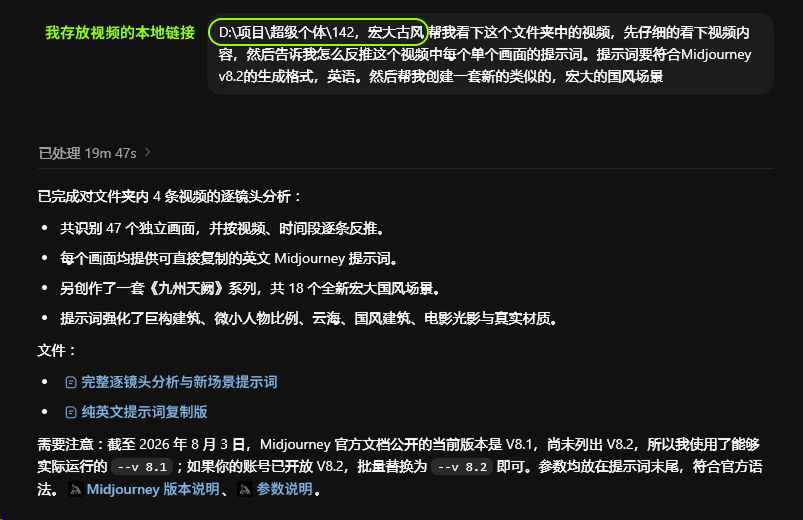
这段提示词主要完成三件事:
第一,要求 Codex 先看视频,而不是只根据“宏大古风”四个字自由发挥。
第二,要求按独立镜头拆解。这样得到的是一组具体的场景提示词,而不是一段笼统的风格描述。
第三,明确输出格式,包括英文提示词、Midjourney v8.2参数和一套新的原创场景。
Codex 会根据镜头切换,分析每个画面的建筑主体、环境、人物数量、构图、光线和比例关系,然后输出可以直接测试的图片提示词。
不过,反推得到的第一版提示词只是起点,并不一定马上符合自己的审美。
第二步:每修改一次,就生成图片测试一次
第一轮生成后,我发现画面虽然宏大,但元素过多,缺少参考视频中的克制感。
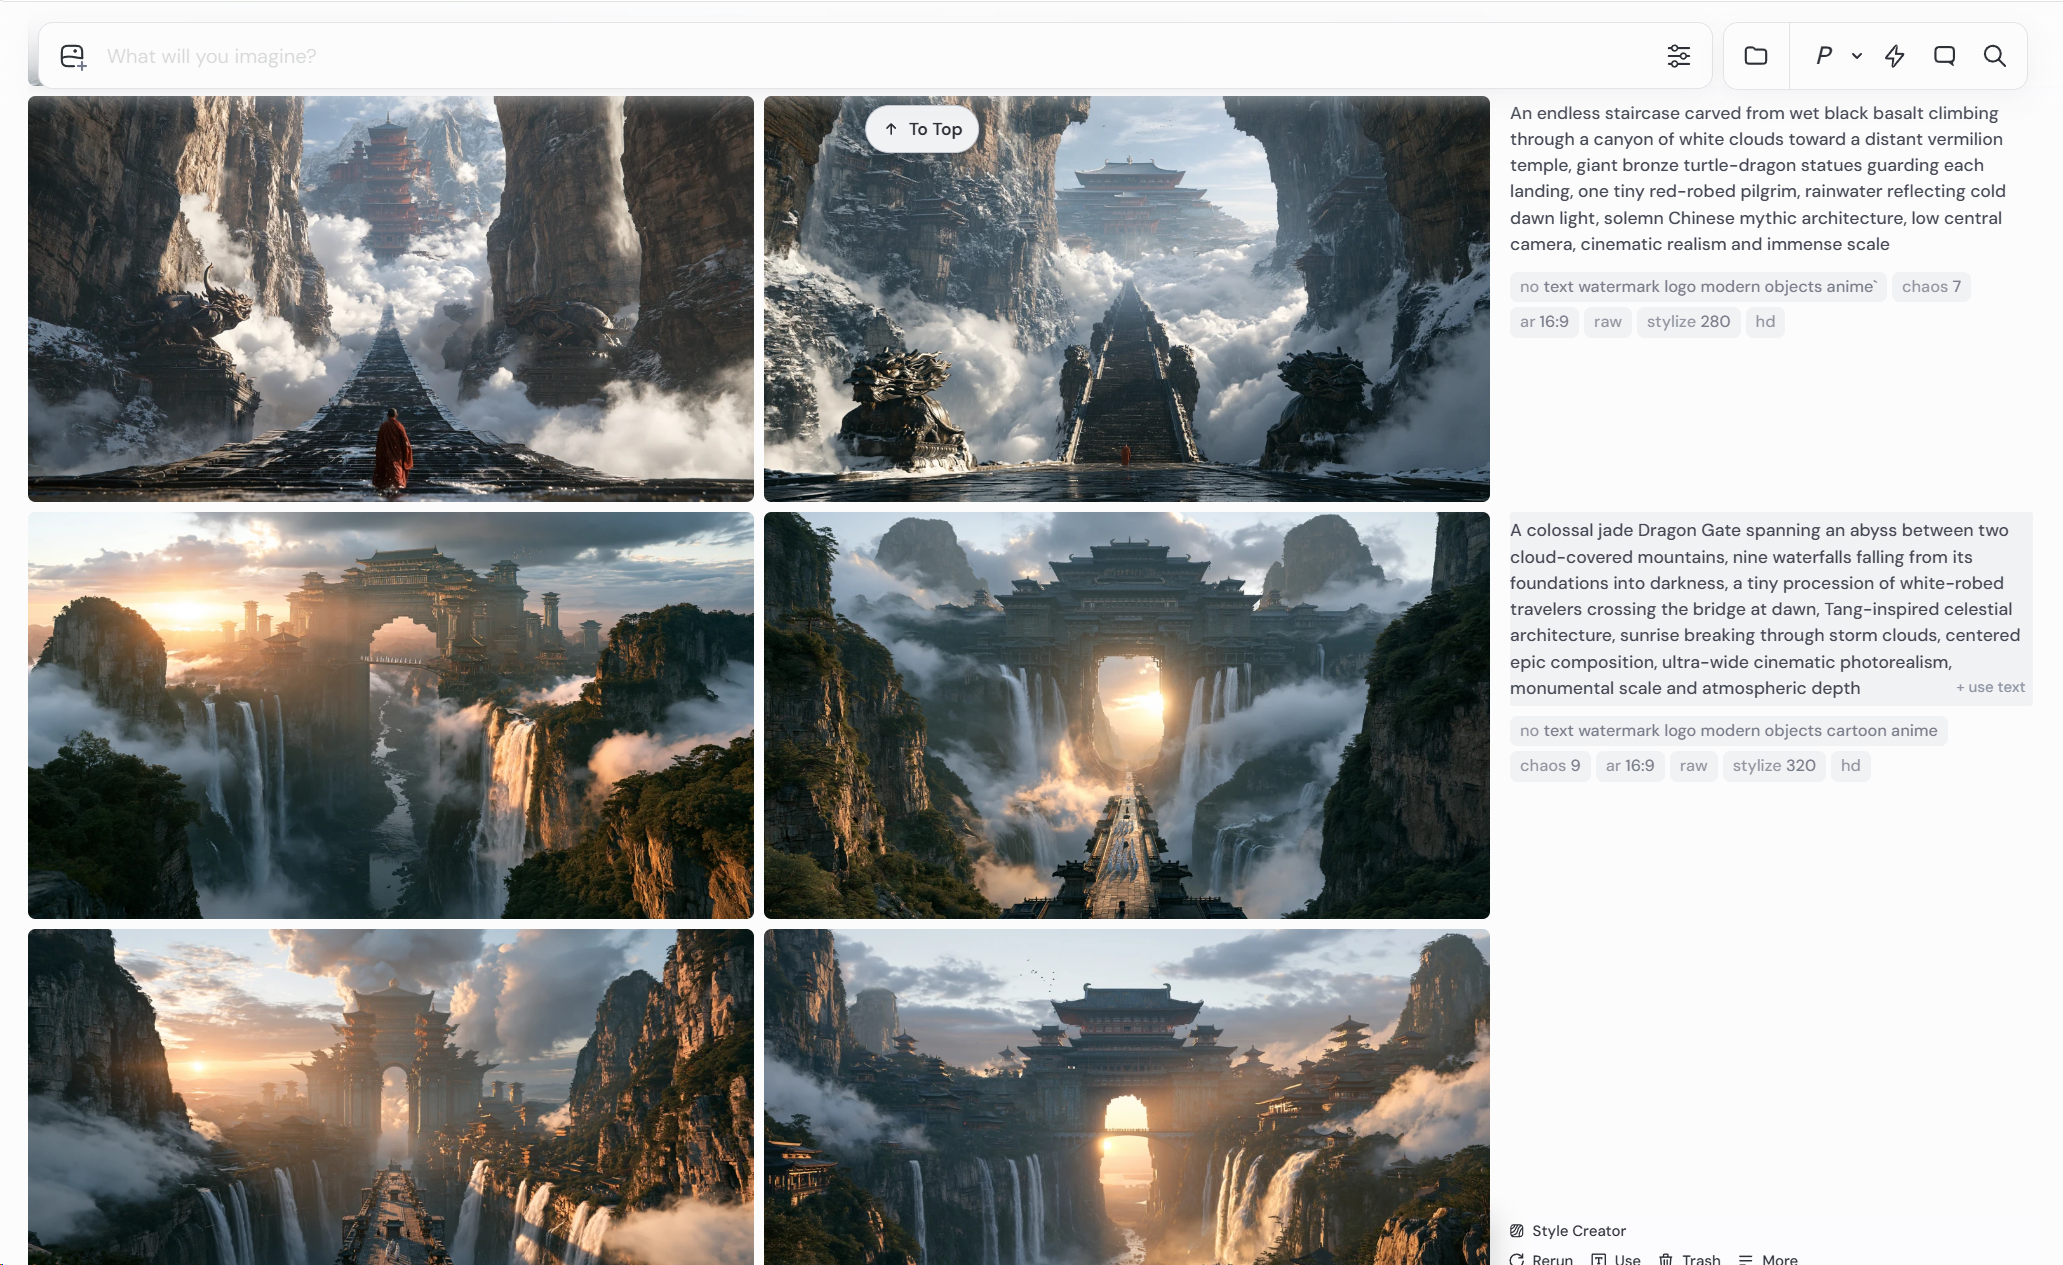
第一轮图片
于是我继续反馈:
现在的画面有些繁杂了,你看看原视频,都是很简约的场景,但是对比出宏大感,还有原视频中都是只有1-3个角色。
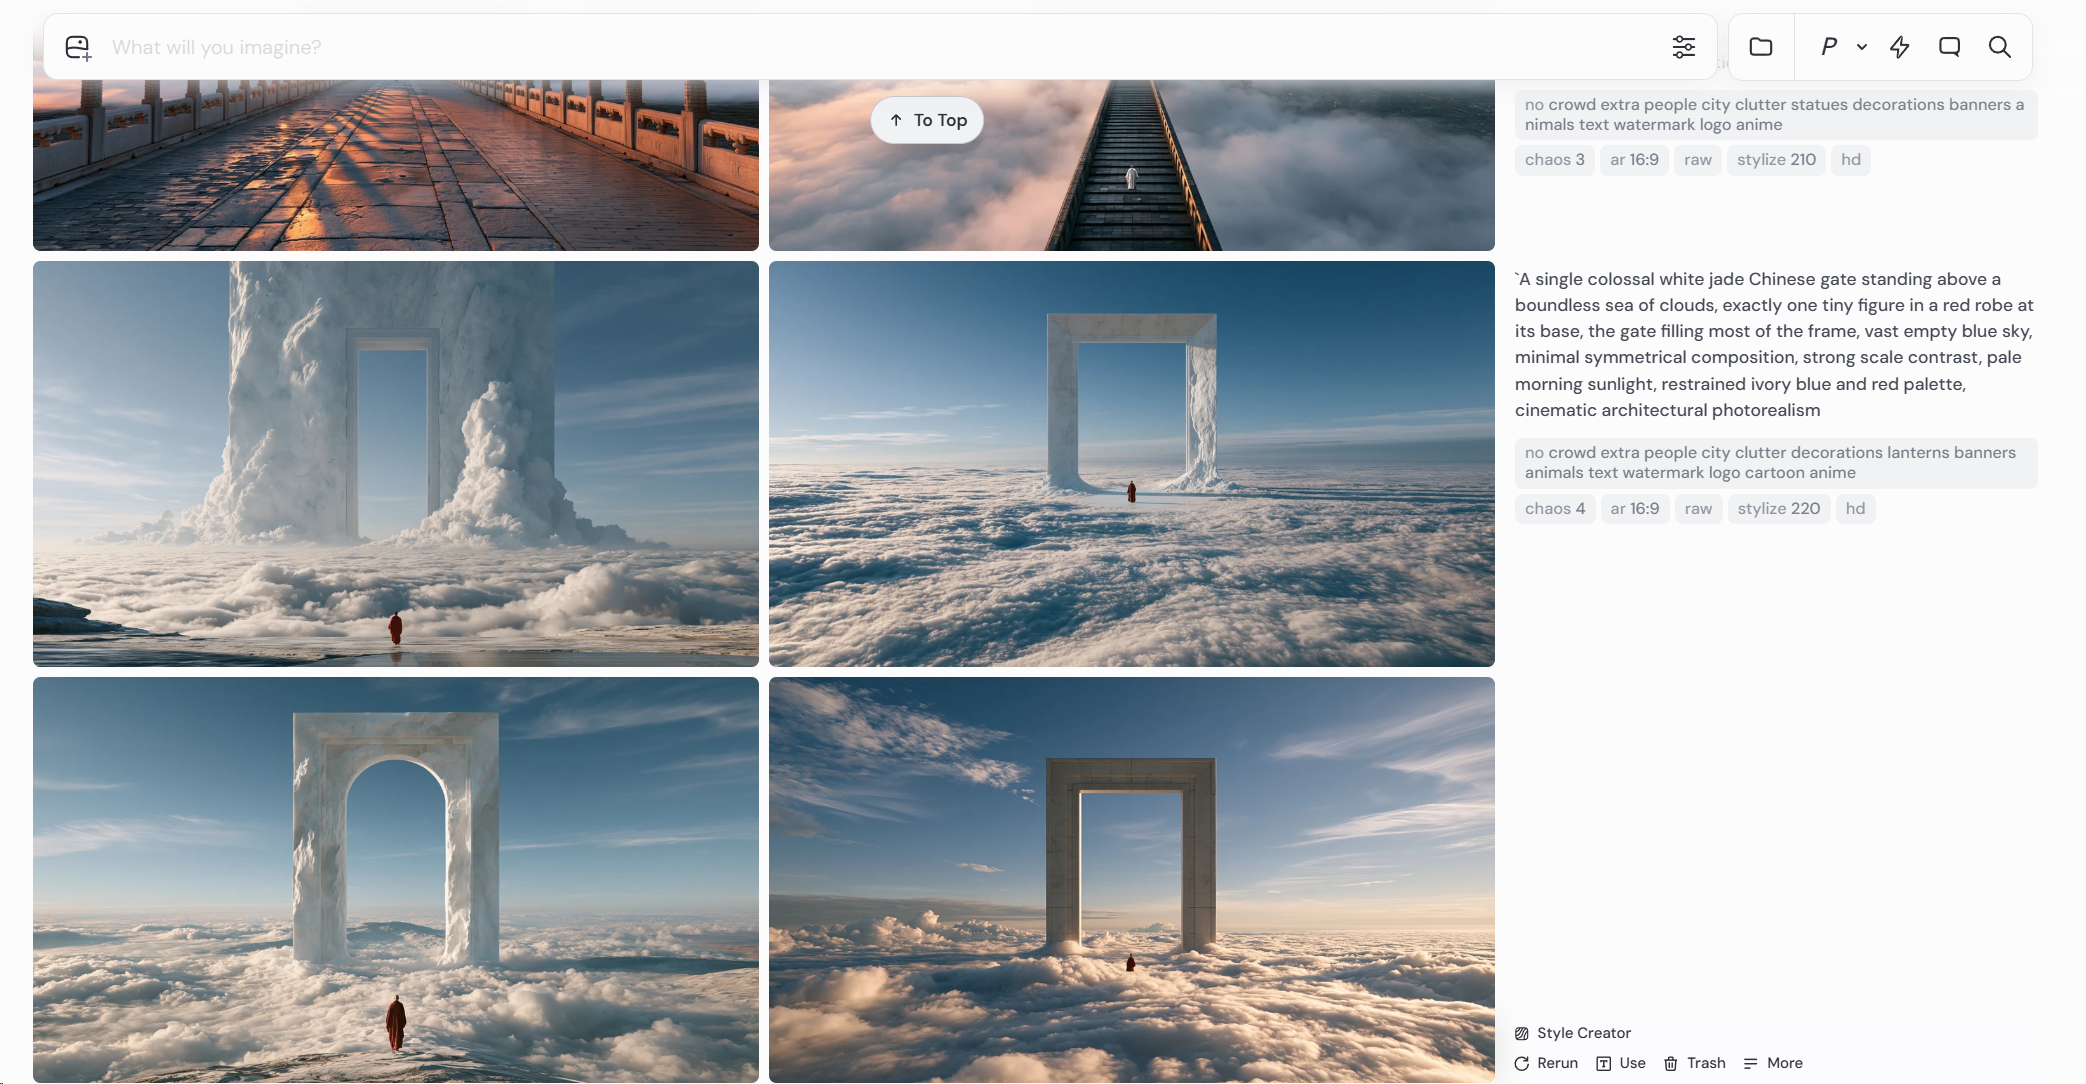
第二轮图片
修改后,画面又变得过于空,仙家气质和中式建筑细节不足。我继续补充:
我要的主要是仙家云海、天宫的质感,人物是女角色,然后中式美学。现在的太简约了,你先给我5段提示词。
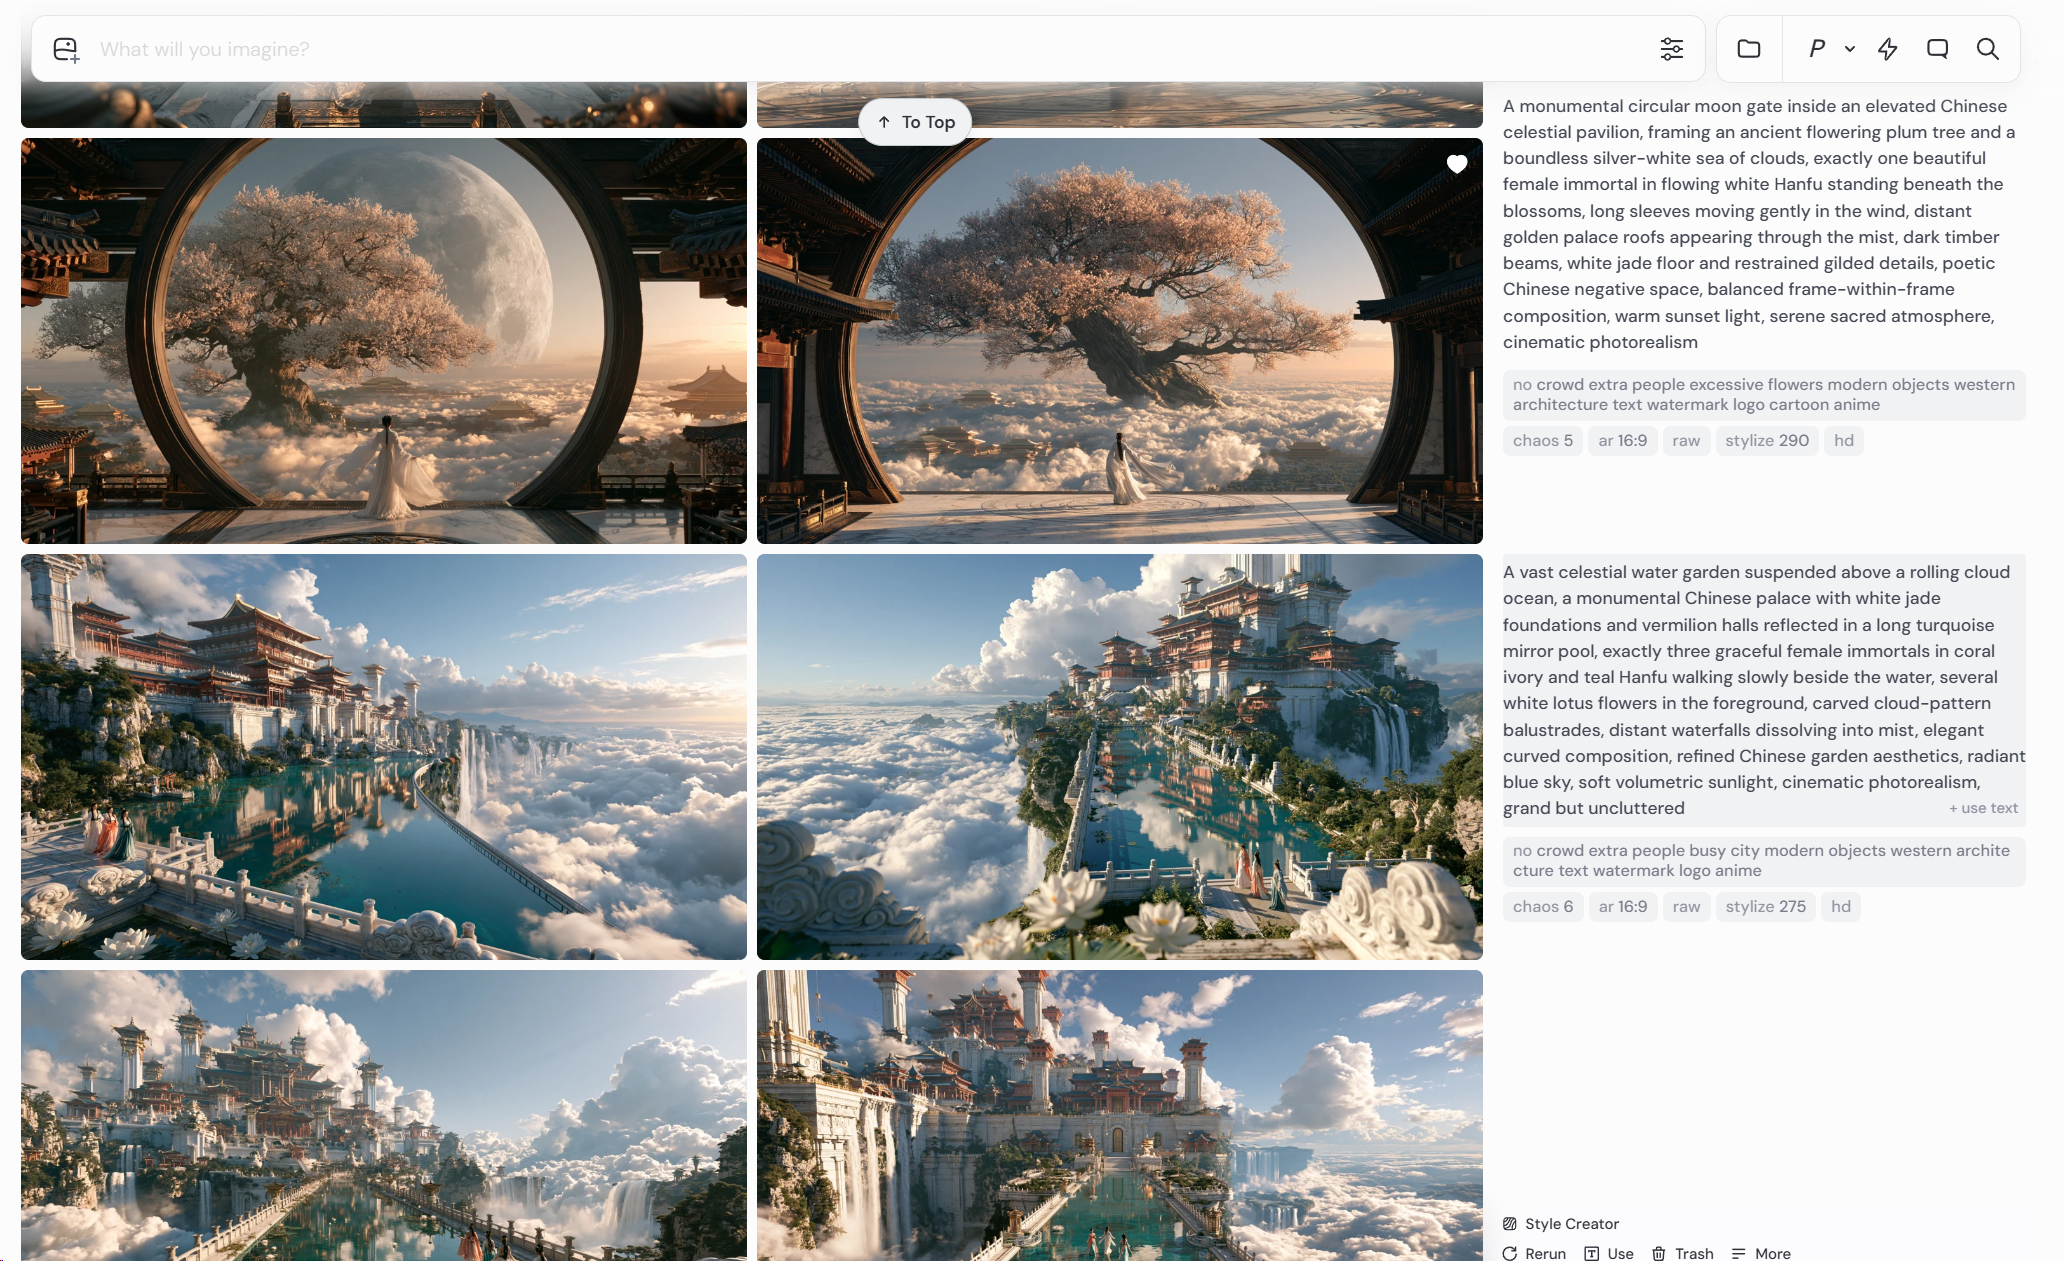
第三轮图片
接下来,画面方向已经接近,但建筑体量仍然不够,我再次反馈:
有些对了,但是现在少了一些宏大感。
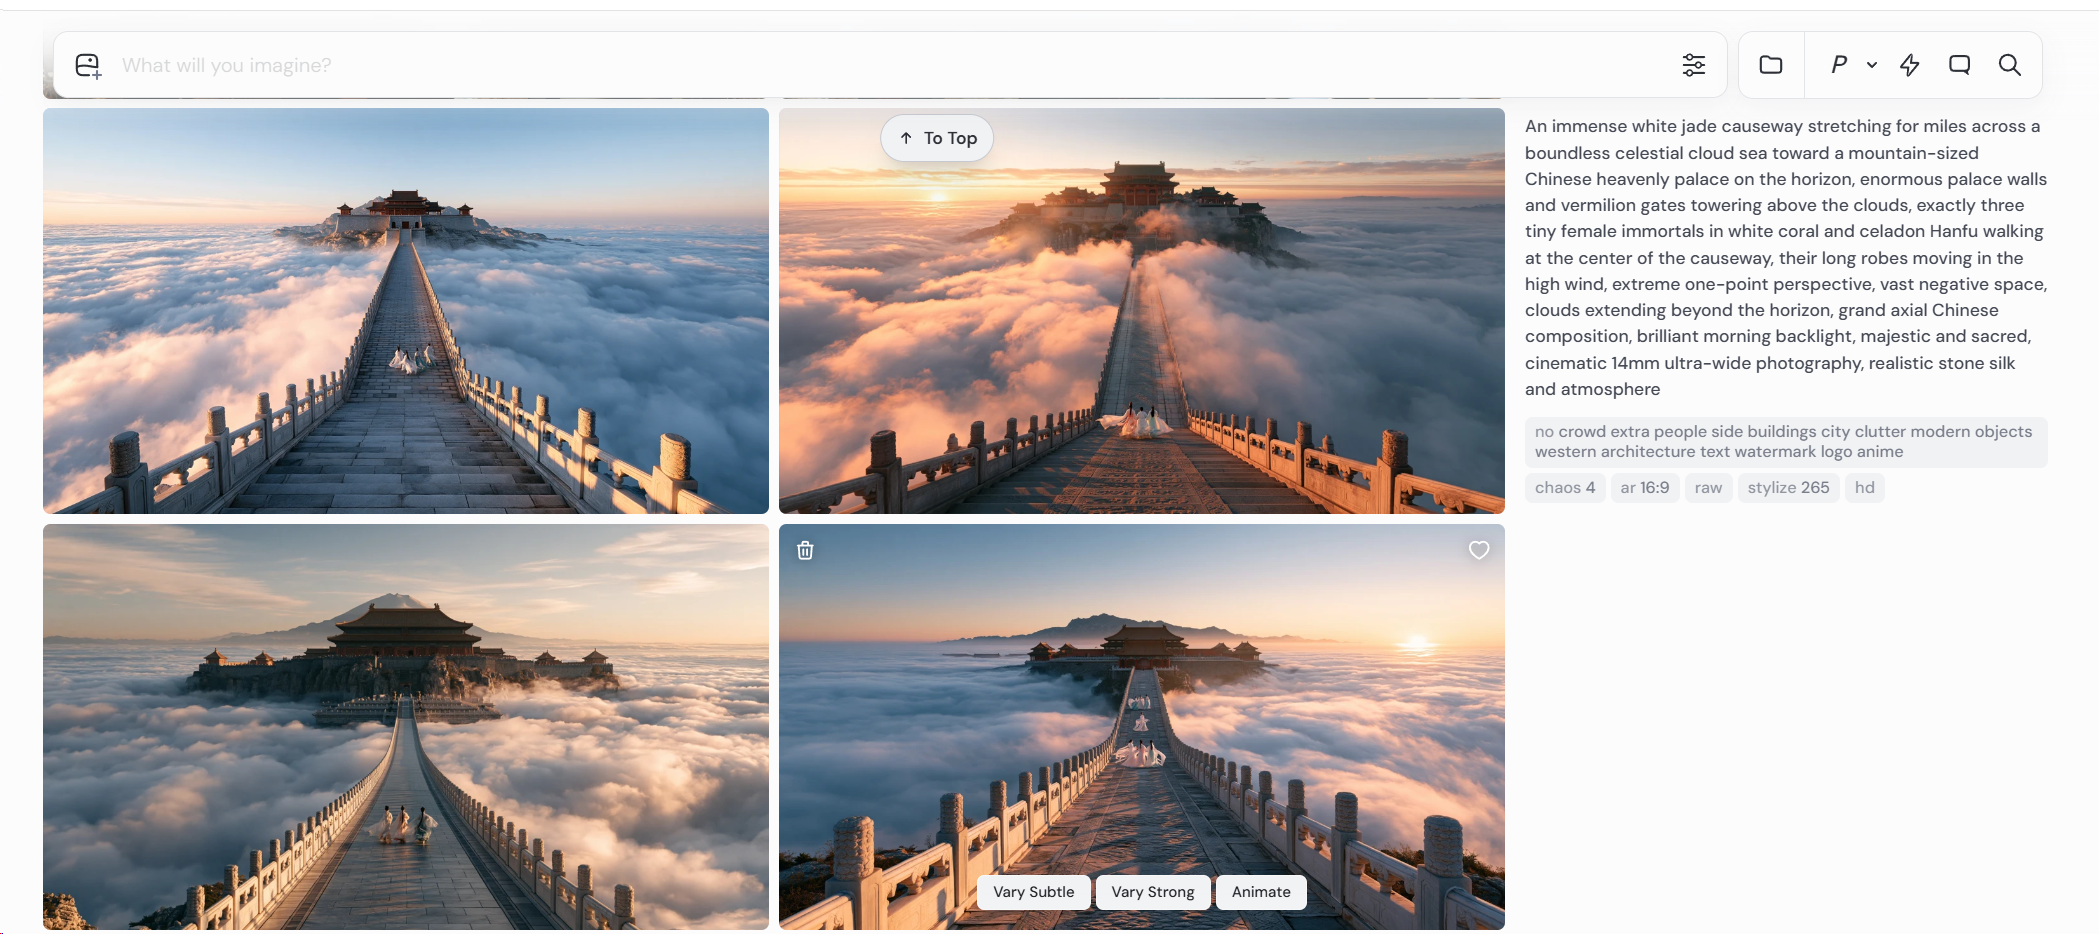
第四轮图片
继续生成后,部分图片又变得像普通景区或网红风景照,于是我指出最具体的问题:
怎么变成像网红风景照了啊,有点太正常了。
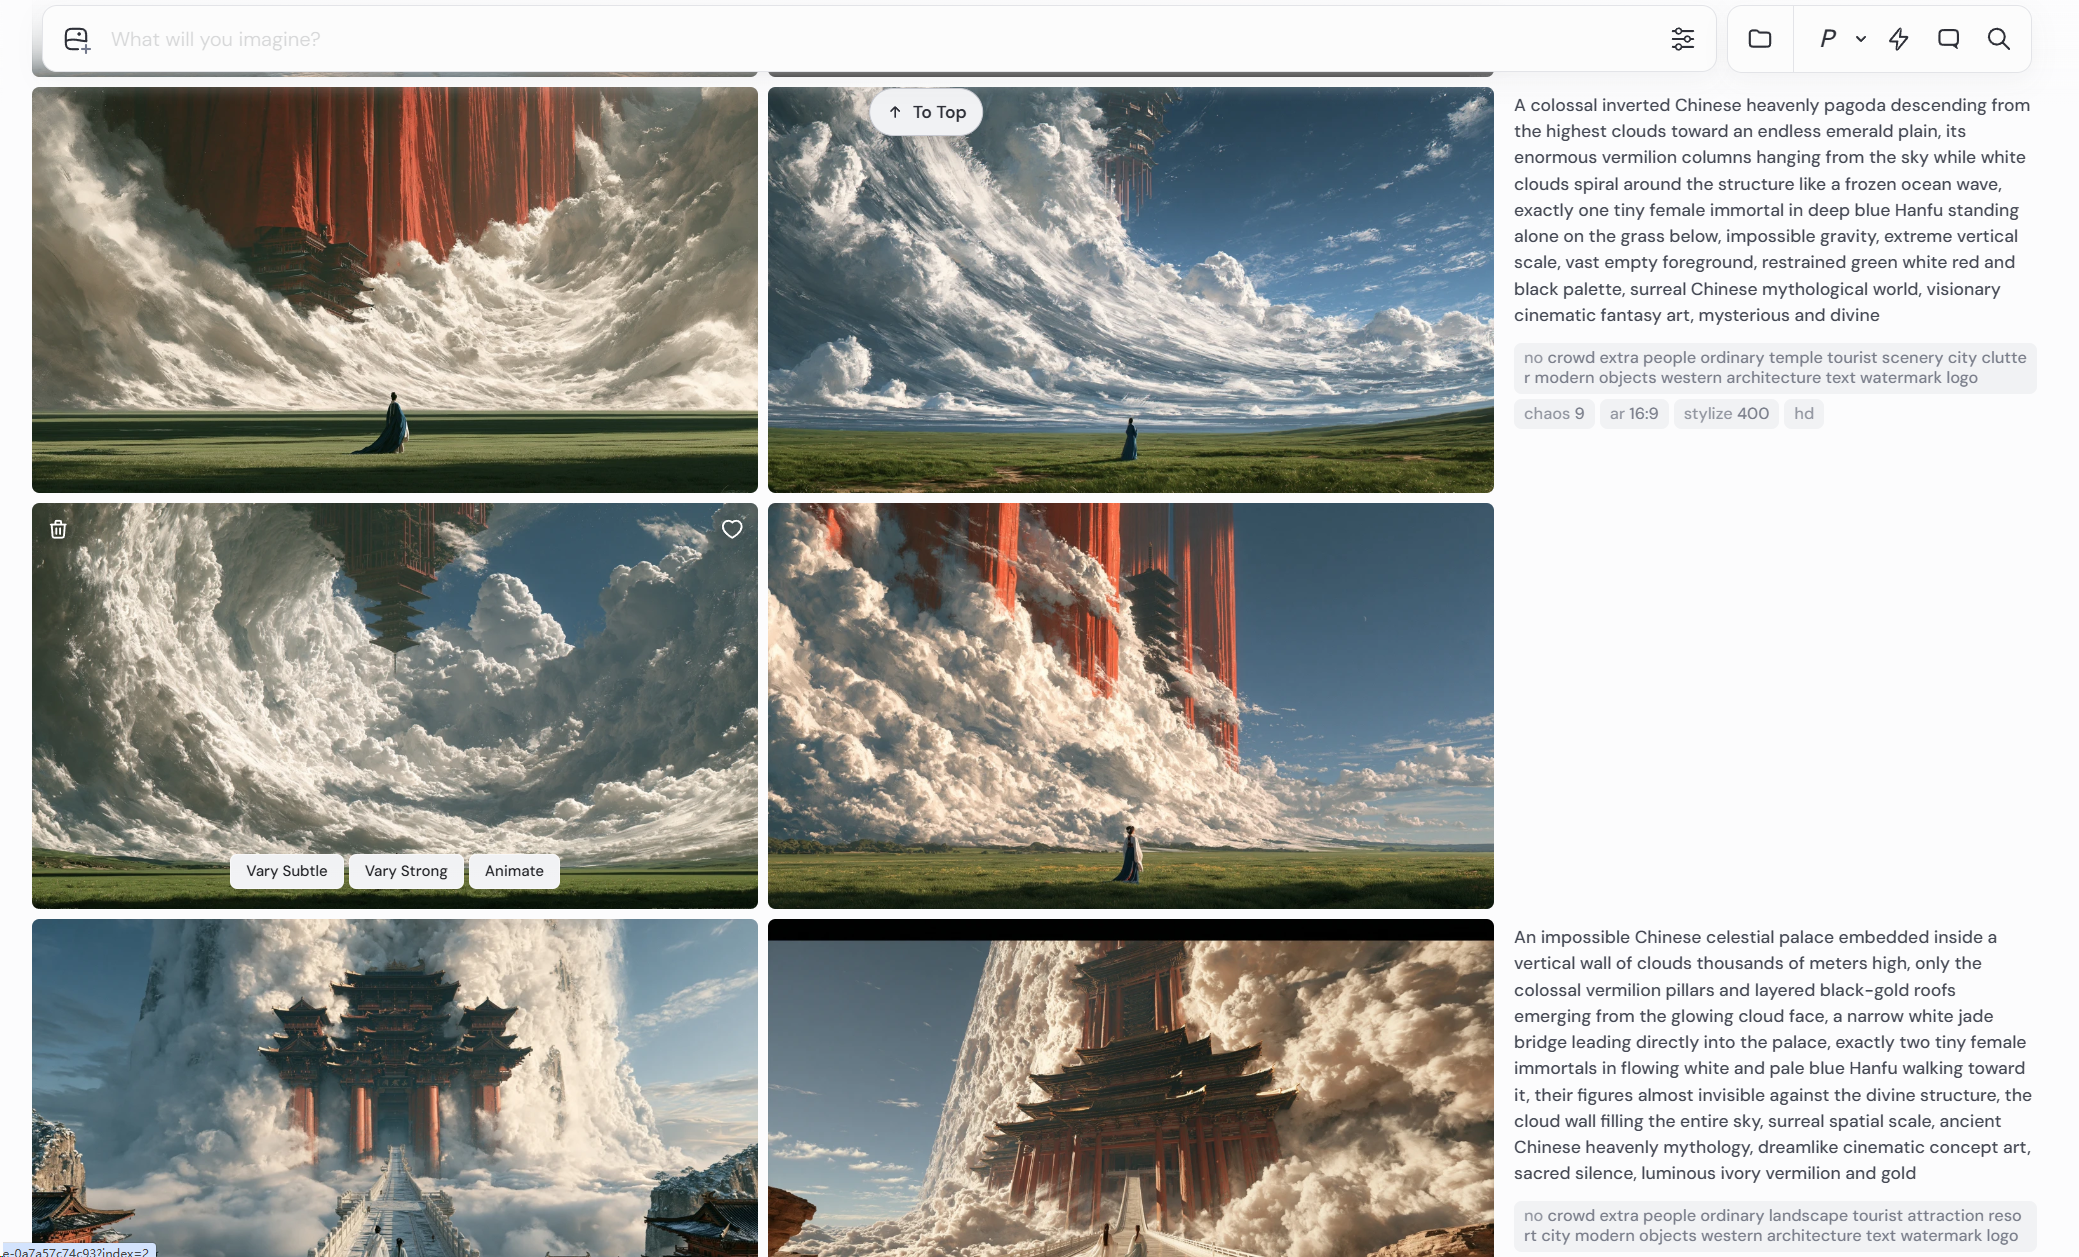
第五轮图片
这一轮反馈非常关键。
画面之所以显得普通,是因为提示词中使用了过多“风景摄影”“建筑摄影”和“真实景区”式的描述,却缺少超现实空间法则。
下面是几段最终方向较准确的图片提示词:
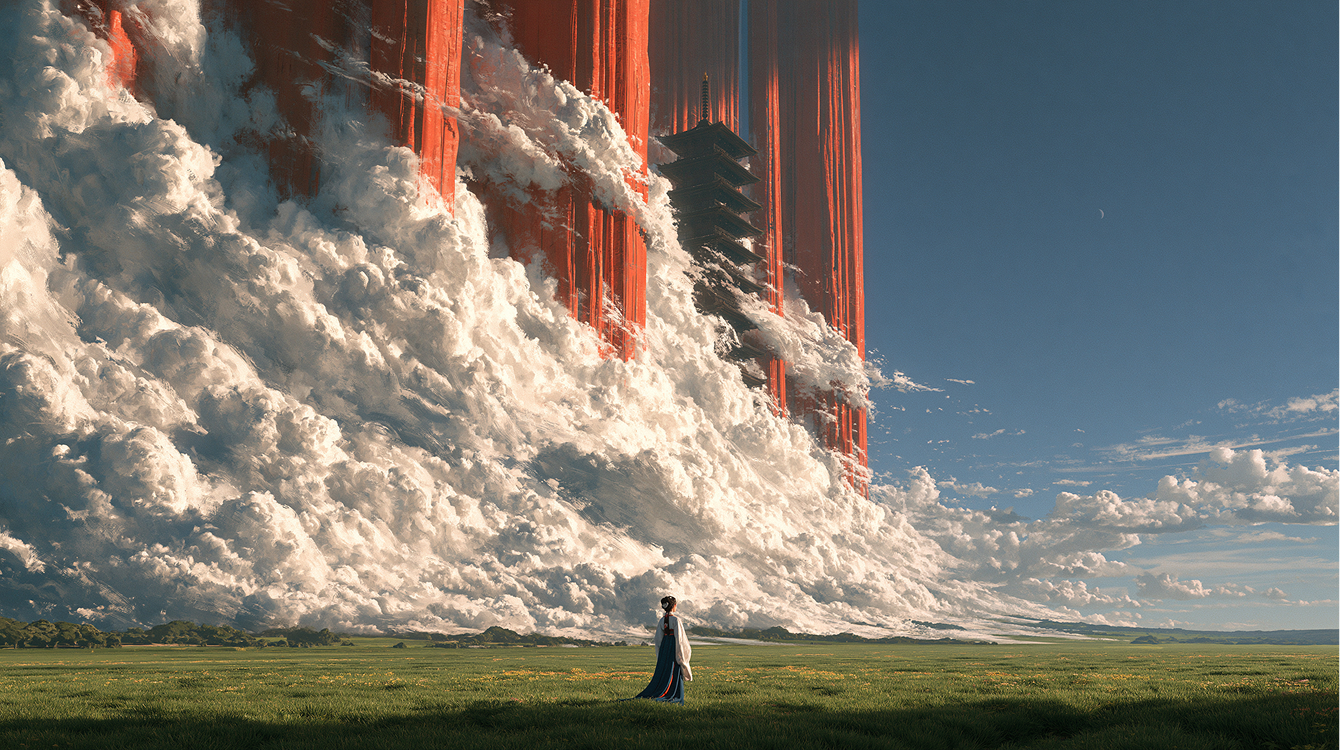
提示词1:
A colossal inverted Chinese heavenly pagoda descending from the highest clouds toward an endless emerald plain, its enormous vermilion columns hanging from the sky while white clouds spiral around the structure like a frozen ocean wave, exactly one tiny female immortal in deep blue Hanfu standing alone on the grass below, impossible gravity, extreme vertical scale, vast empty foreground, restrained green white red and black palette, surreal Chinese mythological world, visionary cinematic fantasy art, mysterious and divine --no crowd extra people ordinary temple tourist scenery city clutter modern objects western architecture text watermark logo --chaos 9 --ar 16:9 --stylize 400 --hd
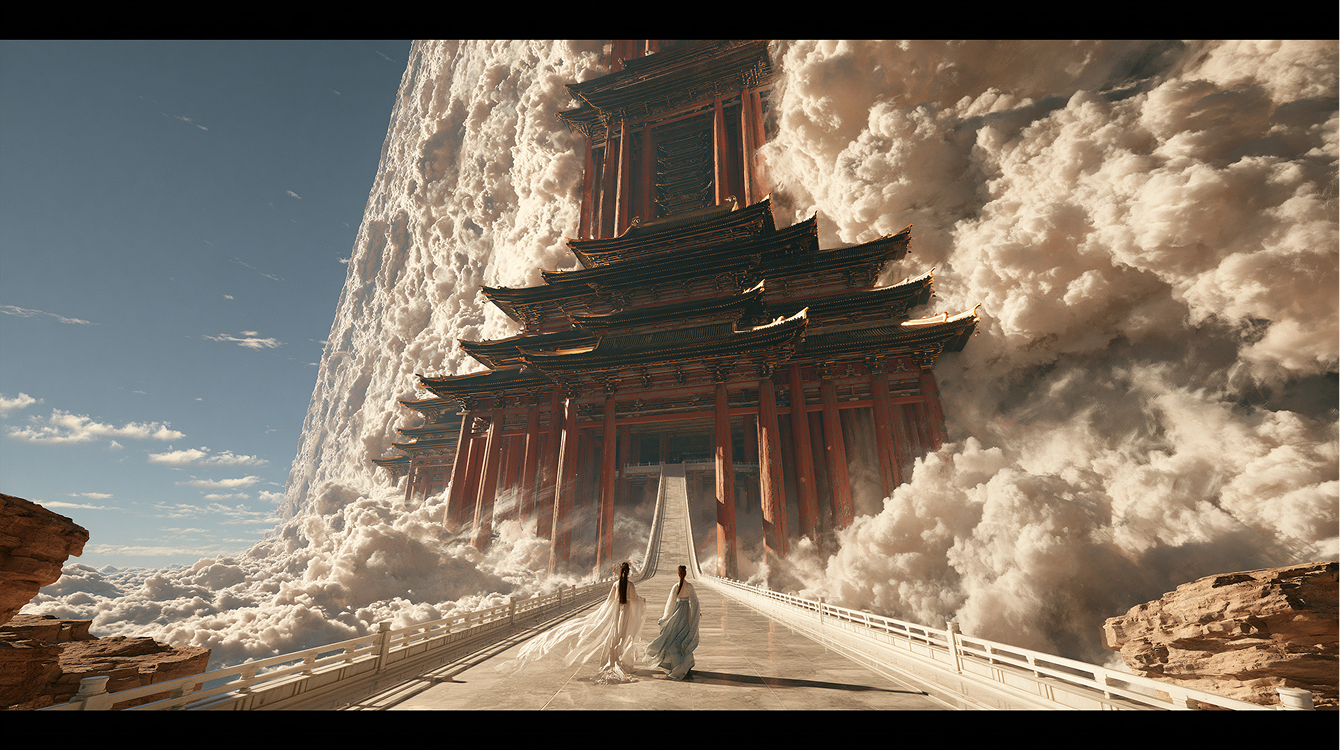
提示词2:
An impossible Chinese celestial palace embedded inside a vertical wall of clouds thousands of meters high, only the colossal vermilion pillars and layered black-gold roofs emerging from the glowing cloud face, a narrow white jade bridge leading directly into the palace, exactly two tiny female immortals in flowing white and pale blue Hanfu walking toward it, their figures almost invisible against the divine structure, the cloud wall filling the entire sky, surreal spatial scale, ancient Chinese heavenly mythology, dreamlike cinematic concept art, sacred silence, luminous ivory vermilion and gold --no crowd extra people ordinary landscape tourist attraction resort city modern objects western architecture text watermark logo --chaos 7 --ar 16:9 --stylize 380 --hd
提示词3:
A monumental circular celestial gate larger than a mountain floating above a silent sea of clouds, a gigantic moon suspended perfectly inside the opening, an immense Chinese heavenly palace built along the inner edge of the circle, its vermilion halls appearing to curve upward against gravity, exactly three tiny female immortals standing on a black mirror-like platform before the gate, flowing ivory coral and celadon Hanfu, impossible celestial geometry, vast negative space, elegant Chinese symmetry, dreamlike mythological concept art, silver blue and muted gold light --no crowd extra people normal architecture tourist attraction city stars clutter modern objects text watermark logo anime --chaos 8 --ar 16:9 --stylize 410 --hd
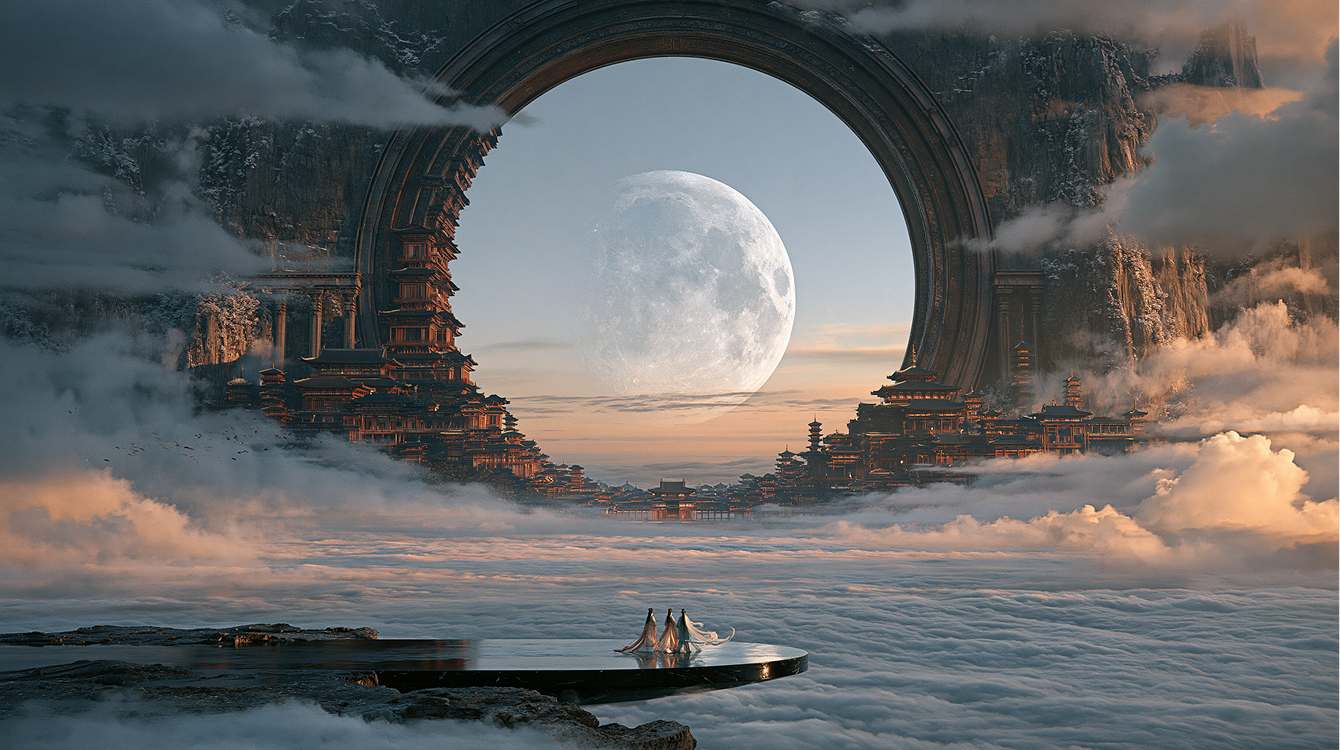
提示词4:
An immense Chinese heavenly palace resting upon a vast river flowing horizontally through the sky, the glowing water pouring over both edges into a bottomless sea of clouds, monumental black roofs and vermilion halls floating like a sacred mountain, exactly one tiny female immortal in red Hanfu standing on a curved white jade causeway below, impossible celestial physics, extreme difference in scale, large areas of luminous cloud and empty sky, poetic Chinese mythology, ethereal gold and blue light, grand cinematic fantasy concept art, richly believable materials but an unreal divine world --no tourist photography ordinary palace city crowd extra people boats decorations modern objects text watermark logo cartoon anime --chaos 8 --ar 16:9 --stylize 410 --hd
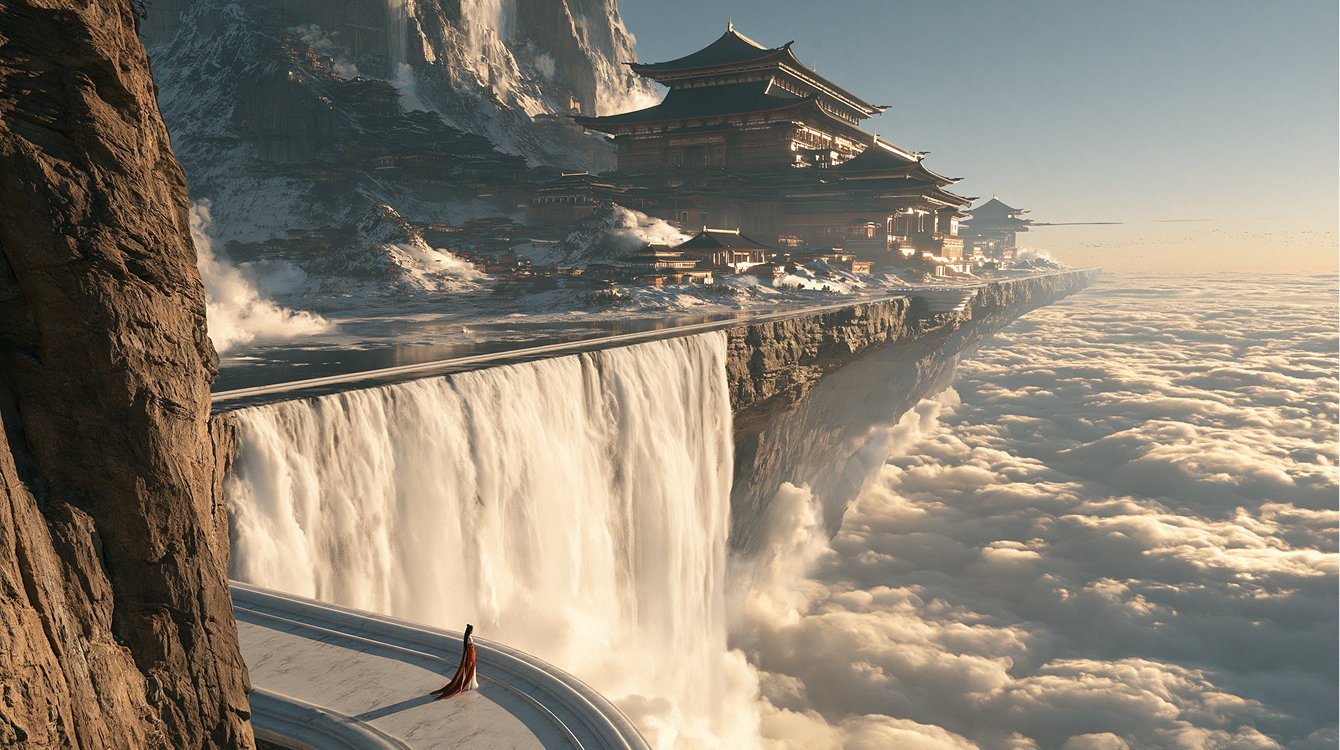
提示词5:
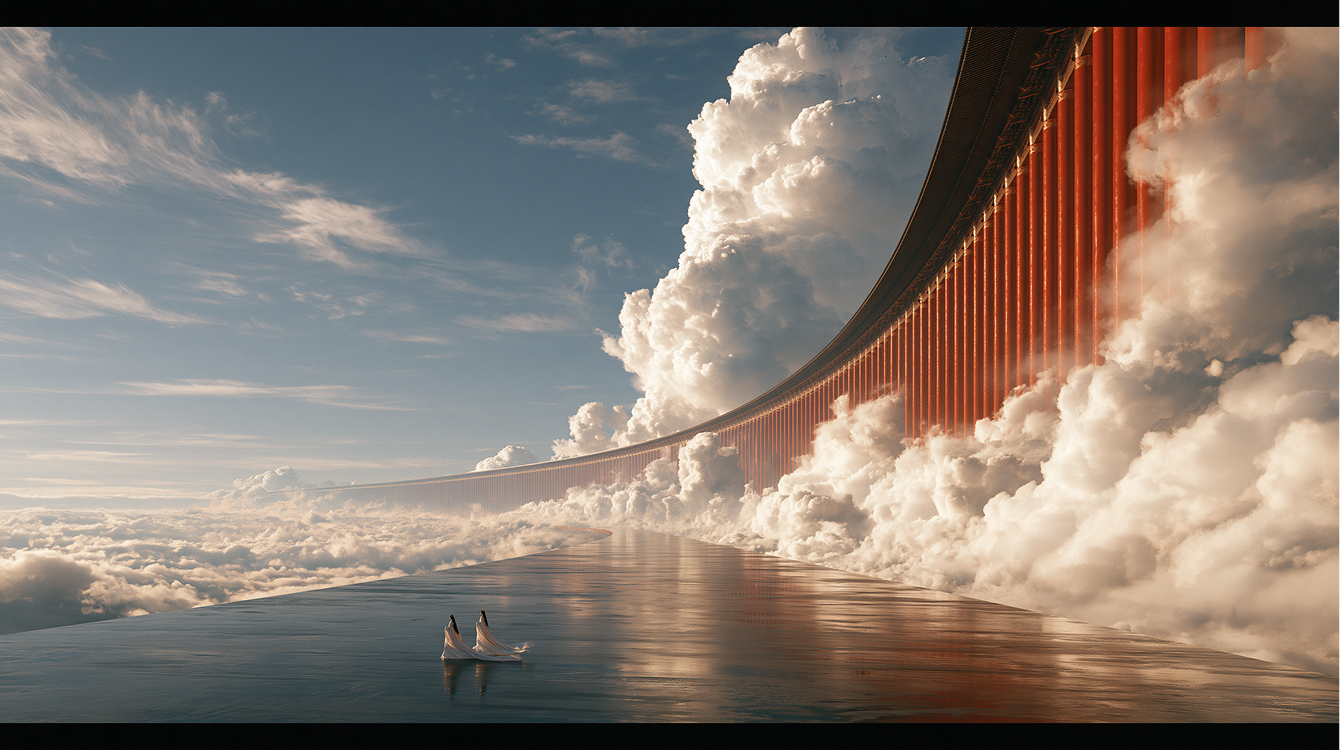
An impossibly long vermilion Chinese palace colonnade extending above a sea of clouds and gradually curving upward across the sky, its repeating monumental pillars disappearing into bright celestial mist, exactly two tiny female immortals in flowing white Hanfu walking on the dark reflective floor, no other architecture, surreal perspective, overwhelming scale created by repetition and emptiness, restrained red black white and gold palette, sacred Chinese heavenly atmosphere, cinematic fantasy concept art --no tourist photography ordinary corridor city crowd extra people furniture decorations modern objects text watermark logo cartoon anime --chaos 7 --ar 16:9 --stylize 380 --hd
如何更有效地修改提示词
不要只说“效果不好”或“再高级一点”,因为模型无法判断具体应该改哪里。
更有效的方法是指出肉眼可见的问题:
-
元素太多:删除城市、队伍、灯海、雕像和次要建筑。
-
画面太空:增加一个中式建筑主体或一个自然元素。
-
不够宏大:让建筑超出画面边缘,并把人物缩小到画面面积的百分之一以内。
-
太像景区:删除旅游摄影语言,加入一种不可能的空间规则。
-
人物太抢眼:要求人物只作为比例参照,不做近景肖像。
-
中式特征不足:明确门阙、斗拱、飞檐、朱柱、白玉台阶或月洞门。
-
画面太乱:每张图只保留一个建筑主体和一种主要环境。
每次只集中解决一两个问题,然后重新生成图片。
如果一次修改太多内容,就很难判断究竟是哪一句提示词产生了作用。
第三步:把满意的图片转换成视频提示词
我使用的视频提示词模板如下:
你是一位擅长宏大中式幻想场景的电影导演和图生视频提示词专家。
接下来,用户只会上传一张图片,不会提供文字说明。请仔细识别图片内容,并直接生成一段可用于图生视频模型的中文提示词。
生成前在内部完成以下判断,但不要输出分析过程:
识别画面的核心建筑,包括天宫、殿宇、门阙、长廊、祭殿、楼阁、月门、石阶、城墙或其他中式建筑。
识别主要环境,包括云海、草原、沙漠、水面、瀑布、山崖、雾气、月亮和天空。
准确识别画面中的女性角色数量、服装颜色、所在位置和朝向。不得增加、删除或复制人物。
判断前景、中景、远景、视觉中心、消失点和建筑延伸方向。
根据画面结构自动选择最合适的一种主要运镜,不要同时堆叠多种复杂运镜:
画面有道路、长桥、石阶、长廊或中心消失点:采用低机位缓慢向前推进。
建筑从画面侧面向远方延伸:采用低机位横向移动,利用前后景视差表现体量。
建筑高耸、人物位于下方:采用缓慢推进并轻微向上仰拍。
画面是月门、圆形建筑或中心对称构图:保持严格居中,缓慢穿越或靠近中心。
画面是草原或沙漠:镜头贴近地面缓慢移动,让前景草叶或沙纹形成视差。
画面包含悬崖、云海或瀑布:镜头缓慢升高或轻微侧移,逐渐显露建筑与深渊的尺度关系。
画面已有非常完整的宏大构图:只做极缓慢推进,不破坏原始构图。
视频运动必须遵循以下层级:
建筑始终稳定、庄严,不变形、不摇晃、不生长。
云海缓慢翻涌并绕过建筑基础,远处云层产生清晰的空间视差。
瀑布持续向下倾泻,水雾缓慢扩散;草原形成大面积低缓风浪;沙漠只出现贴地流沙和少量沙雾。
女性角色保持克制,只允许缓慢行走、静静站立、轻微回头或抬头。
女角色的衣袖、裙摆和长发随风缓慢飘动,动作优雅,不抢夺建筑主体。
光线可以缓慢穿过云层,形成体积光和明暗变化,但不得突然闪烁。
强调建筑与女性角色之间极端的尺寸反差,人物应始终显得渺小。
运镜缓慢、稳定、庄严,具有史诗感和神性,避免旅游宣传片和普通风景航拍的感觉。
整段视频为一个连续长镜头,无剪辑、无转场、无突然加速。
最终提示词必须包含:
开始画面的构图和镜头高度。
唯一的主要运镜方向。
前景、中景和远景的动态变化。
云雾、草地、沙尘、水流或光线的自然运动。
女性角色的走动,人物动态和衣袂动态。
中式神话、仙家气韵、宏大尺度、空间纵深与庄严氛围。
建筑和人物稳定性约束。
输出要求:
只输出一段完整的中文视频提示词,不要标题、解释、分析、分点或备选方案。控制在200至300字,适合生成5秒、16:9、电影级、单镜头的宏大中式幻想视频。结尾自然加入以下限制:
保持原图构图、建筑形态、人物数量、人物身份和服装一致,禁止增加人物或建筑,禁止面部变形、肢体畸变、建筑扭曲、画面抖动、镜头突变、快速运动、现代元素、文字、水印和卡通质感。
将提示词与生成的图片一起交给大语言模型,他会直接推导出合适的视频提示词。
第四步:使用可灵3.0生成视频
进入可灵3.0的图生视频功能,上传已经确认的图片作为首帧,再粘贴大语言模型输出的视频提示词。
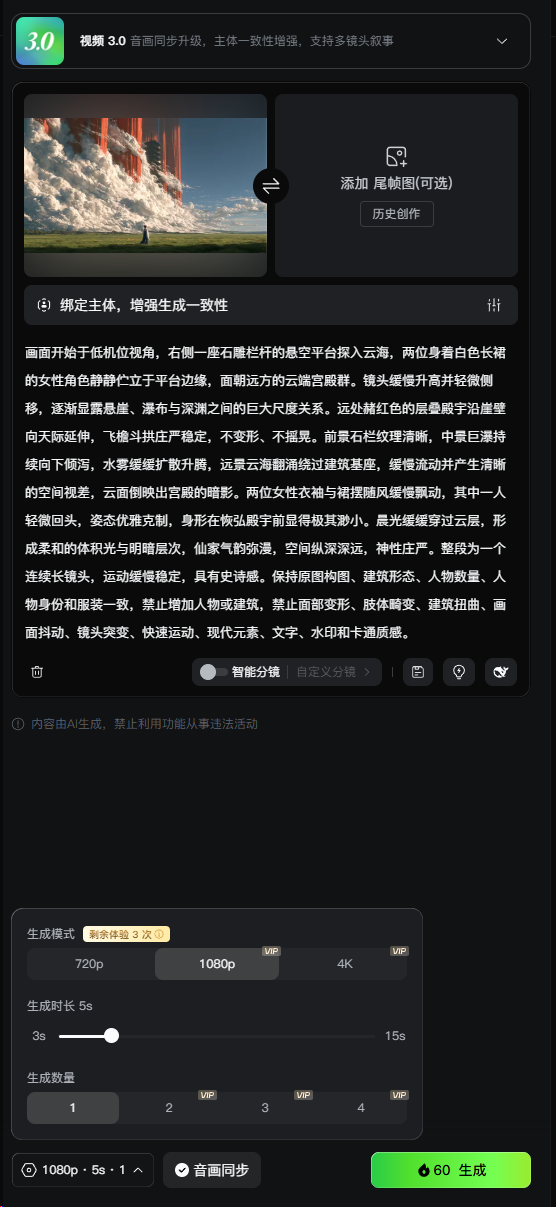
点击生成即可
第五步:在剪映中完成拼接
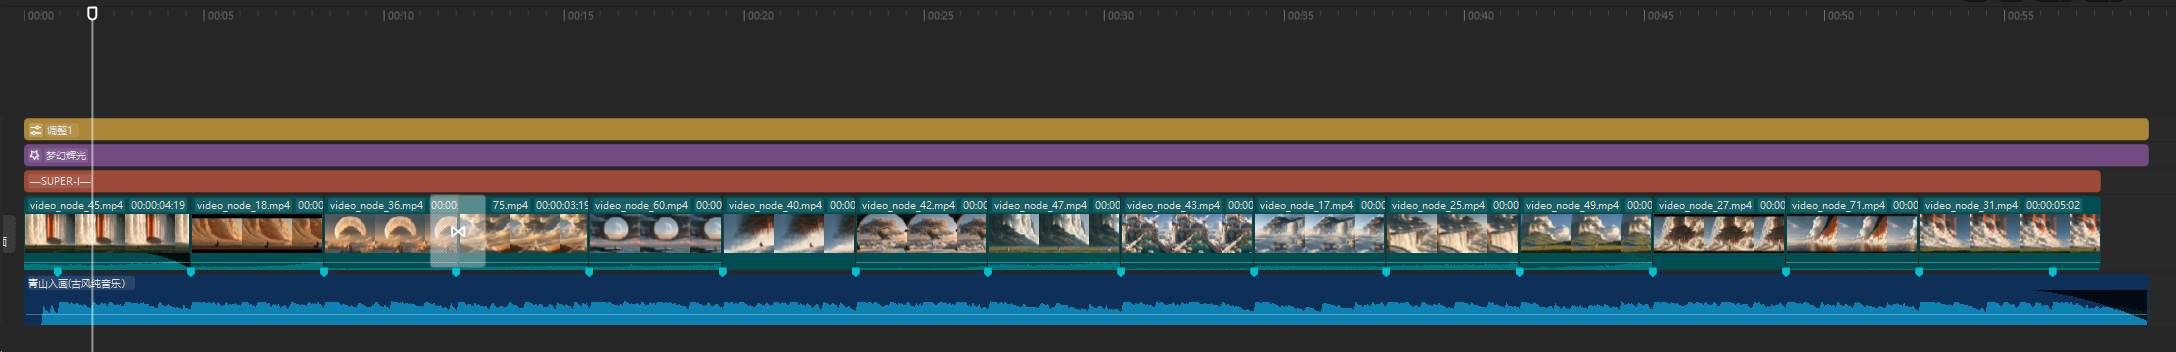
所有视频片段生成后,导入剪映进行排列。
我的最终成片约59秒,使用了云海殿宇、巨型瀑布、月门、草原、沙漠与长廊等场景,并通过超宽画幅强化空间感。
我还添加了滤镜和特效。
音乐建议选择节奏舒展、层次逐渐增强的古风配乐。
最后把成熟流程封装成 Skill
完成多轮测试后,我把已经稳定的图片提示词规则和视频运镜模板制作成了一个 Skill(粘贴至网址自动下载):
https://superi.mfdemo.cn/chaoji/2026/08/03/6a706f1340ddd.zip
Skill可以完成两类任务。
第一类是生成图片提示词。
只需要输入想要的场景,例如:
使用skill,生成5个宏大中式沙漠场景,建筑不一定是天宫,可以使用门阙、祭殿和楼阁,画面中只有一至三位女性角色。
Skill会自动套用已经确认的规则,输出符合Midjourney的英文图片提示词。
第二类是生成视频提示词。
调用 Skill 后直接上传生成图片,它会分析画面中的建筑、环境、人物和透视关系,再输出一段适合5秒图生视频的中文提示词。
Skill的价值不是让模型替代审美判断,而是保存已经验证有效的工作方法,避免每次重新解释人物数量、画面密度、空间尺度和视频稳定性。
这套方法真正值得复用的部分
虽然本次案例是宏大中式幻想视频,但其中有几条方法可以用于其他视觉主题。
第一,先分析参考素材,再生成新内容。
先找出反复出现的视觉规律,比直接要求“做一个类似的”更准确。
第二,把审美反馈写成可观察的问题。
“太普通”可以进一步写成“像现实景区,缺少不可能的空间结构”;“不够宏大”可以写成“建筑没有超出画面,人物比例过大”。
第三,小批量生成并及时测试。
先生成三至五张,确认方向后再扩展,比一次生成几十条提示词更节省时间。
第四,静态画面和动态镜头分开处理。
图片提示词负责主体、构图、材质和世界观;视频提示词负责运镜、环境运动、人物动作和稳定性。
第五,把验证过的流程保存成 Skill。
当同类任务会反复出现时,把提示词、限制和检查规则封装起来,可以明显减少重复沟通。
视频生成执行卡
把这节课压缩成一张可执行卡片:看重点、照步骤、避坑,再复制模板直接开做。
这节课不是先追求炫技成片,而是围绕「刺猬星球super-i_AI教程免费在线教学」先把主体、动作、镜头和节奏稳住。
按原文节奏走最稳:先吃透「准备工具/素材/思路」,再把「第一步:让 Codex 逐镜头反推图片提示词」定住,接着处理「第二步:每修改一次,就生成图片测试一次」;最后用「如何更有效地修改提示词」收口。
- 先把「准备工具/素材/思路」里的主体和动作定死。
- 把「第一步:让 Codex 逐镜头反推图片提示词」这一点先定准,再往下走。
- 做完「第二步:每修改一次,就生成图片测试一次」后,先查连贯性和穿帮。
- 把「如何更有效地修改提示词」整理成可复制版本,后面直接复用。
- 把「第三步:把满意的图片转换成视频提示词」整理成可复制版本,后面直接复用。
- 做完「第四步:使用可灵3.0生成视频」后,先查连贯性和穿帮。
不要一上来就生成最终片;先拆镜头、定主体和运动,再逐段生成,否则容易跳轴、穿帮、节奏混乱。
检查主体是否稳定;镜头运动是否明确;前后画面是否连贯;节奏是否服务主题;是否有明显变形或穿帮。
请围绕「刺猬星球super-i_AI教程免费在线教学」帮我做一个可直接执行的方案。
我的目标是:【填写你的具体目标】
我的素材/产品/角色信息是:【填写已有素材和限制】

请输出:核心创意、分镜表、每个镜头的画面描述、视频生成提示词、剪辑顺序和成片自检清单。要求主体稳定、动作明确、镜头连贯。